AI 엔지니어링 Decision Models
#AI
#LLM
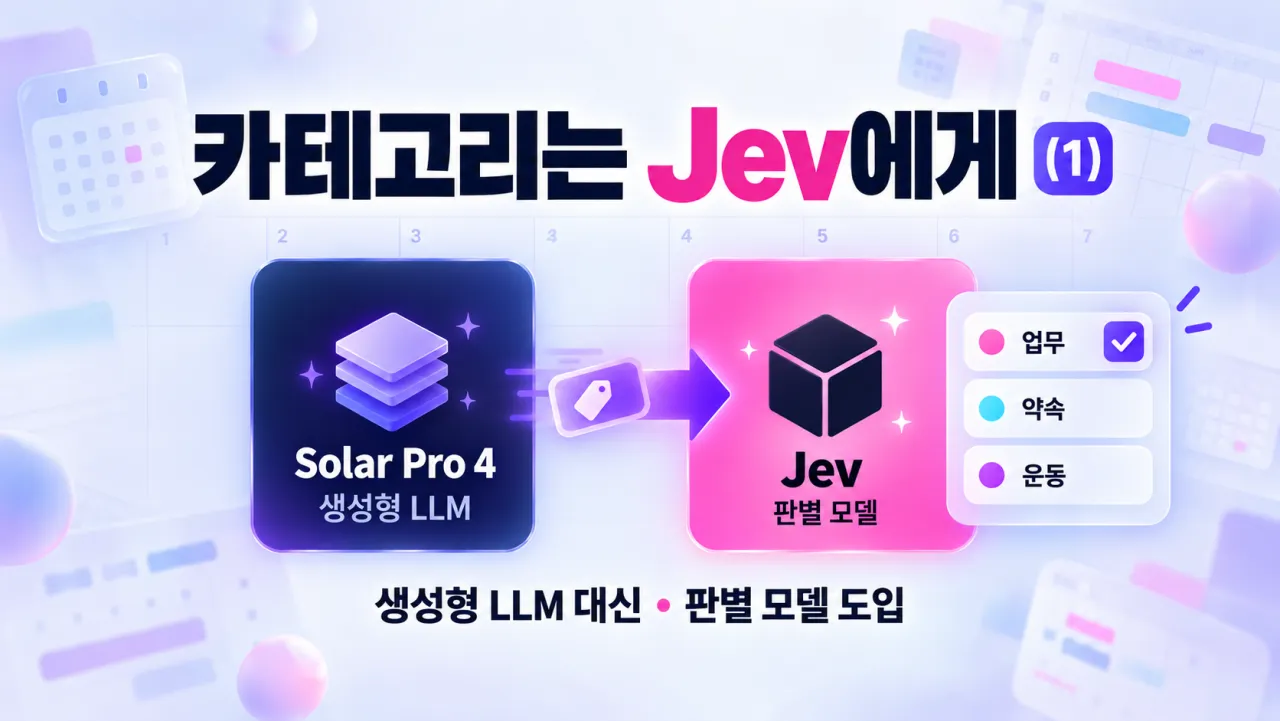
일정 AI의 카테고리만 Jev에게 (1): 생성형 LLM 대신 판별 모델 도입하기
글을 쓰는 생성형 LLM에게 판단을 부탁하던 한계를 넘기 위해 Jev(System 1) 판별 모델을 도입한 과정. 92+30문장 전용 벤치, fan-out 질문 분해를 통한 0.6 문턱 도출과 병렬 폴백 배포 기록
글을 쓰는 생성형 LLM에게 판단을 부탁하던 한계를 넘기 위해 Jev(System 1) 판별 모델을 도입한 과정. 92+30문장 전용 벤치, fan-out 질문 분해를 통한 0.6 문턱 도출과 병렬 폴백 배포 기록
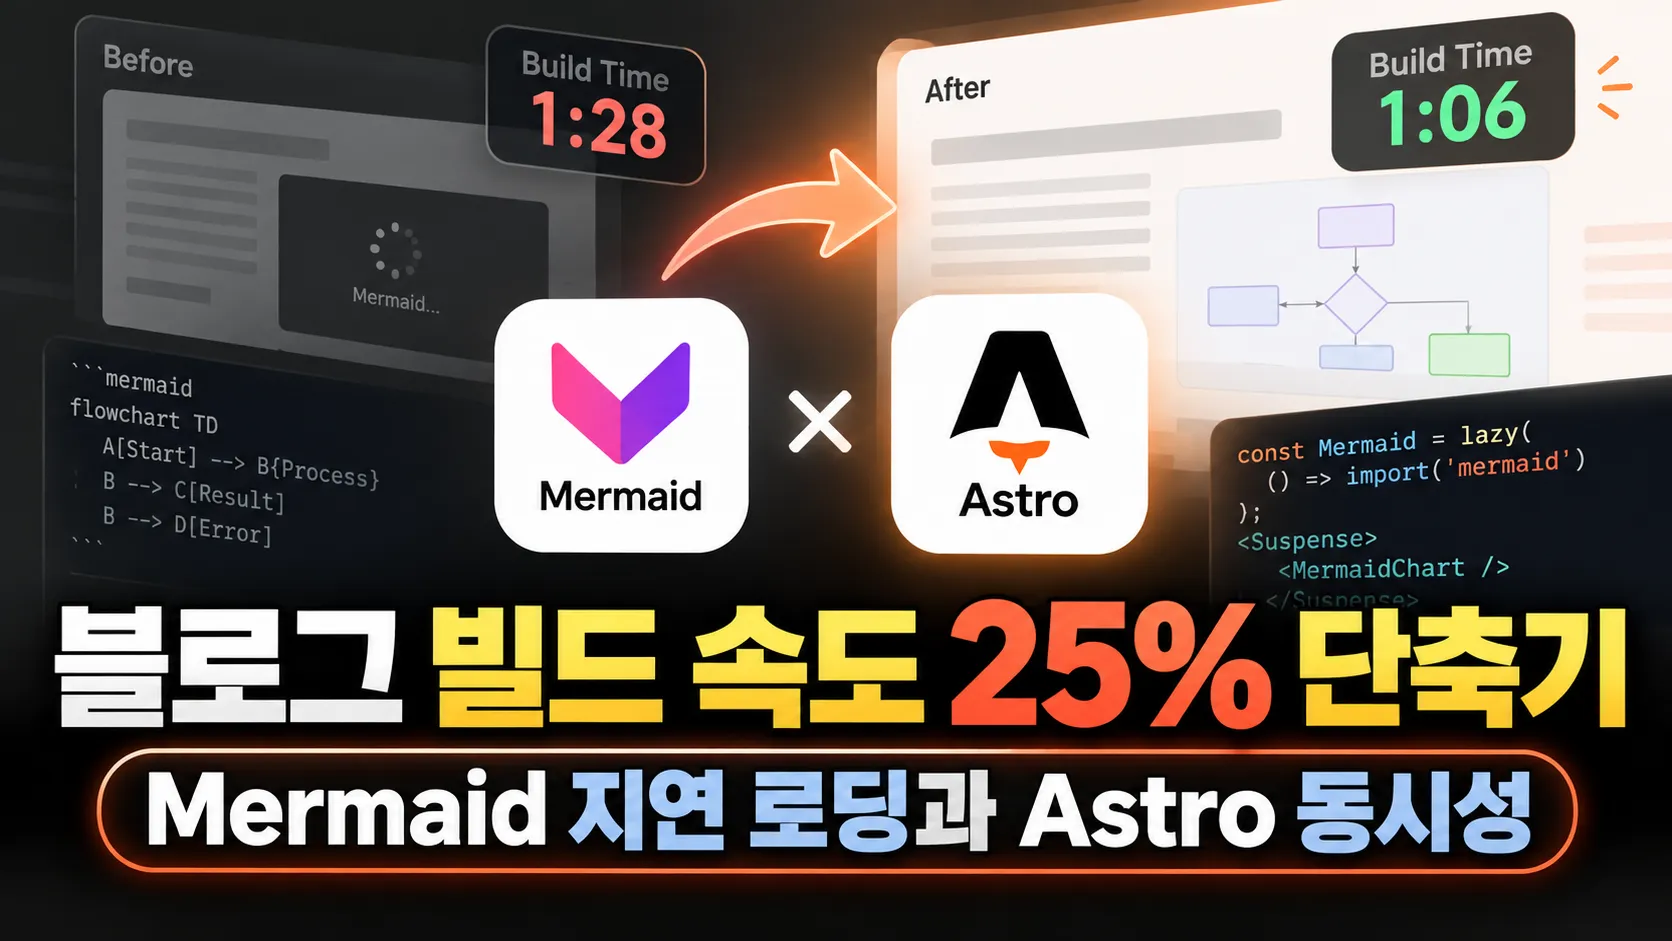
Astro 블로그 빌드 속도를 16.8초에서 12.6초로 줄인 과정. 1,500개 모듈 번들링 병목을 파헤치고, 거대한 Mermaid를 동적 import로 떼어내고 Astro 5 동시성 옵션을 적용한 최적화 기록을 공유합니다.
블로그 RAG의 Qdrant 3개 컬렉션과 수동 임베딩·keepalive를 걷어내고, AI Search 107페이지·271벡터 자동 색인으로 이관한 운영 단순화 회고
12M 토큰 컨텍스트와 sub-quadratic sparse-attention 아키텍처를 내세운 SubQ(subq.ai). 얼리액세스를 신청해두고 이 모델이 어떤 결을 가졌는지 먼저 정리해봤다.
월 $1 Go 플랜으로 commandcode.ai 결제부터 첫 손맛까지. taste-1 자기학습 + DeepSeek V4 Pro 백엔드 조합이 진짜 $1 값을 하는지 며칠 굴려본 첫인상.
자연어 질문을 SQL·차트·인사이트로 잇는 멀티 에이전트를 직접 만들며 배운 것들. 결정론적인 건 코드로, 비결정론적인 것만 LLM에 맡기는 하이브리드 워크플로우로 값싼 모델로도 고성능 LLM+ReAct 구성과 거의 동등한 결과를 낸 개발 회고.
Quest 2의 Textual TUI를 Quest 3 RAG 비교 들어가기 전에 Jupyter Notebook으로 옮긴 이유와 노트북 셀 구성 정리. 직관성·실험 반복성·공유성 세 축으로 결정.
Google AI Edge Gallery로 iPhone에서 Gemma 4 (E2B/E4B)를 돌려본 후기. token/sec·발열·배터리 실측과 온디바이스 LLM이 지금 어디쯤 와 있는걸까?
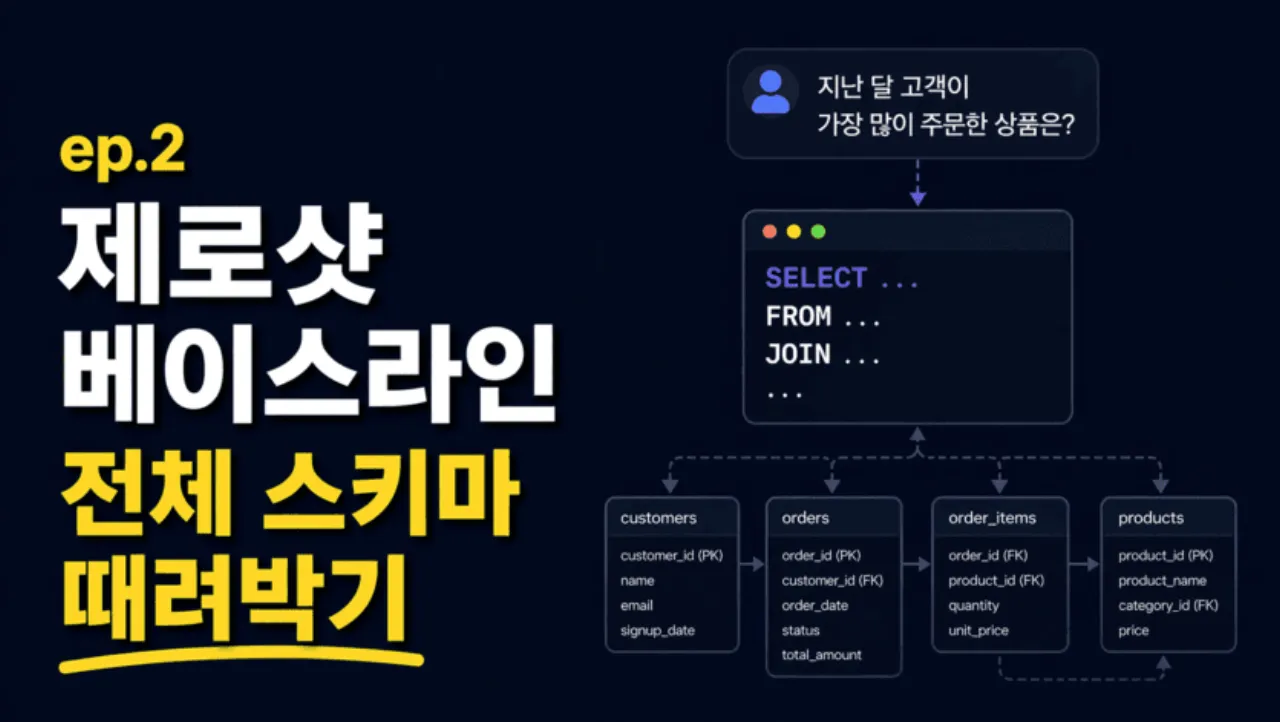
RAG 없이 전체 스키마를 프롬프트에 주입해서 SQL을 생성하는 Naive Baseline 구축. Textual TUI로 반복 테스트 환경까지 만들고, 20개 질문에서 Execution Accuracy 100%를 기록했습니다.
읽어주셔서 고맙습니다.