Decision Models
#AI
#LLM
일정 AI의 카테고리만 Jev에게 (1): 생성형 LLM 대신 판별 모델 도입하기
글을 쓰는 생성형 LLM에게 판단을 부탁하던 한계를 넘기 위해 Jev(System 1) 판별 모델을 도입한 과정. 92+30문장 전용 벤치, fan-out 질문 분해를 통한 0.6 문턱 도출과 병렬 폴백 배포 기록
Category
RAG, 에이전트, LLM을 직접 만들고 실험한 기록 · 15개의 글
글을 쓰는 생성형 LLM에게 판단을 부탁하던 한계를 넘기 위해 Jev(System 1) 판별 모델을 도입한 과정. 92+30문장 전용 벤치, fan-out 질문 분해를 통한 0.6 문턱 도출과 병렬 폴백 배포 기록
자연어 질문을 SQL·차트·인사이트로 잇는 멀티 에이전트를 직접 만들며 배운 것들. 결정론적인 건 코드로, 비결정론적인 것만 LLM에 맡기는 하이브리드 워크플로우로 값싼 모델로도 고성능 LLM+ReAct 구성과 거의 동등한 결과를 낸 개발 회고.
Quest 2의 Textual TUI를 Quest 3 RAG 비교 들어가기 전에 Jupyter Notebook으로 옮긴 이유와 노트북 셀 구성 정리. 직관성·실험 반복성·공유성 세 축으로 결정.
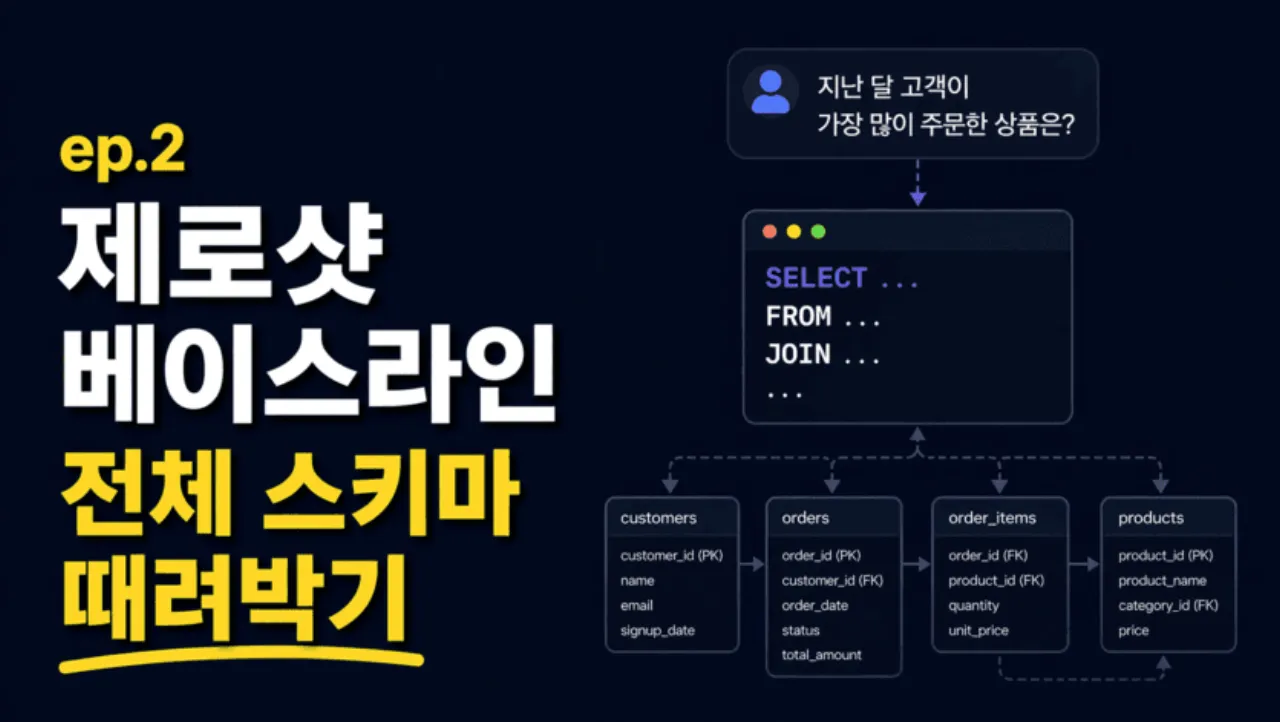
RAG 없이 전체 스키마를 프롬프트에 주입해서 SQL을 생성하는 Naive Baseline 구축. Textual TUI로 반복 테스트 환경까지 만들고, 20개 질문에서 Execution Accuracy 100%를 기록했습니다.
PostgreSQL + pgvector 환경을 만들고, Snowflake 스타일 시맨틱 레이어 YAML을 엔티티 단위로 분해해서 Solar Embedding으로 적재하기까지
공공데이터를 PostgreSQL에 적재하고, 시맨틱 레이어 + pgvector RAG + LLM으로 자연어를 SQL로 변환하는 에이전트를 단계적으로 구현하는 프로젝트 시작
공공데이터로 RAG 뚝딱거려보기 시리즈를 마무리하며 — 무엇을 만들었고, 무엇을 배웠는지
질의 분석, 멀티 소스 라우팅, relevance 기반 fallback까지 넣어 Agentic RAG 실행 루프를 만든 기록
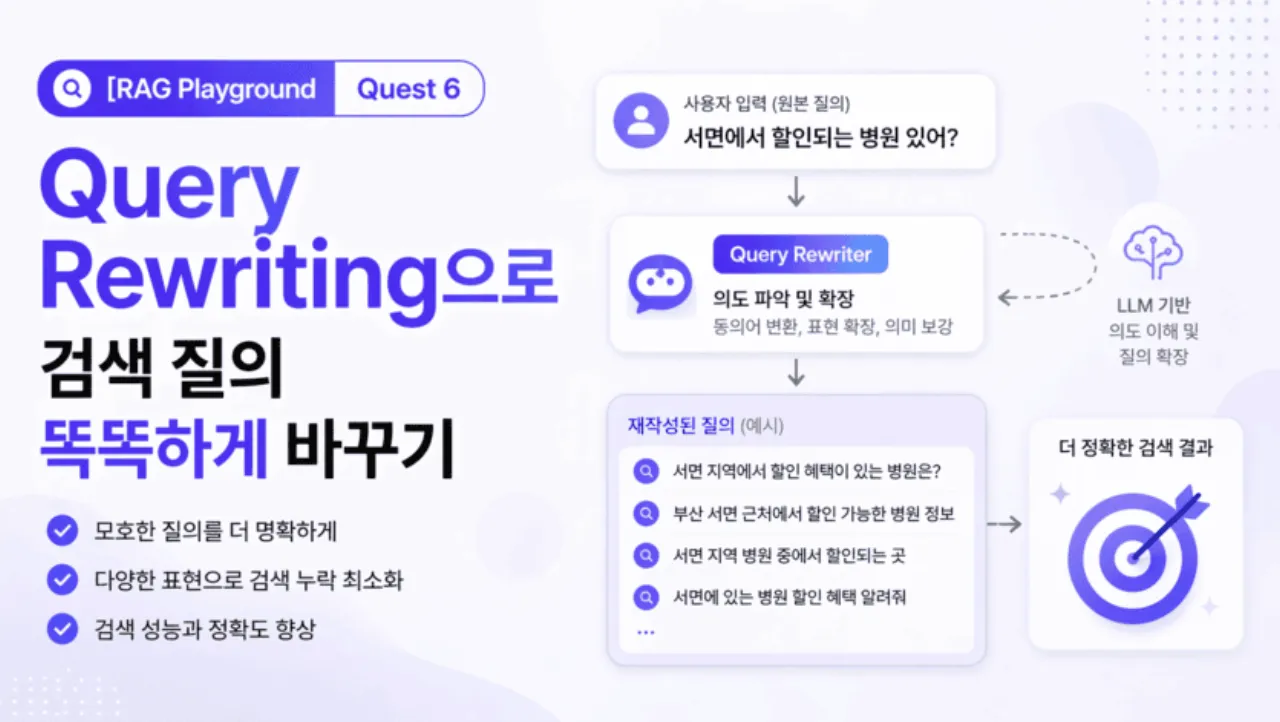
HyDE와 Multi-Query 기법으로 사용자 질의를 재작성해 검색 품질을 향상시키는 실험기
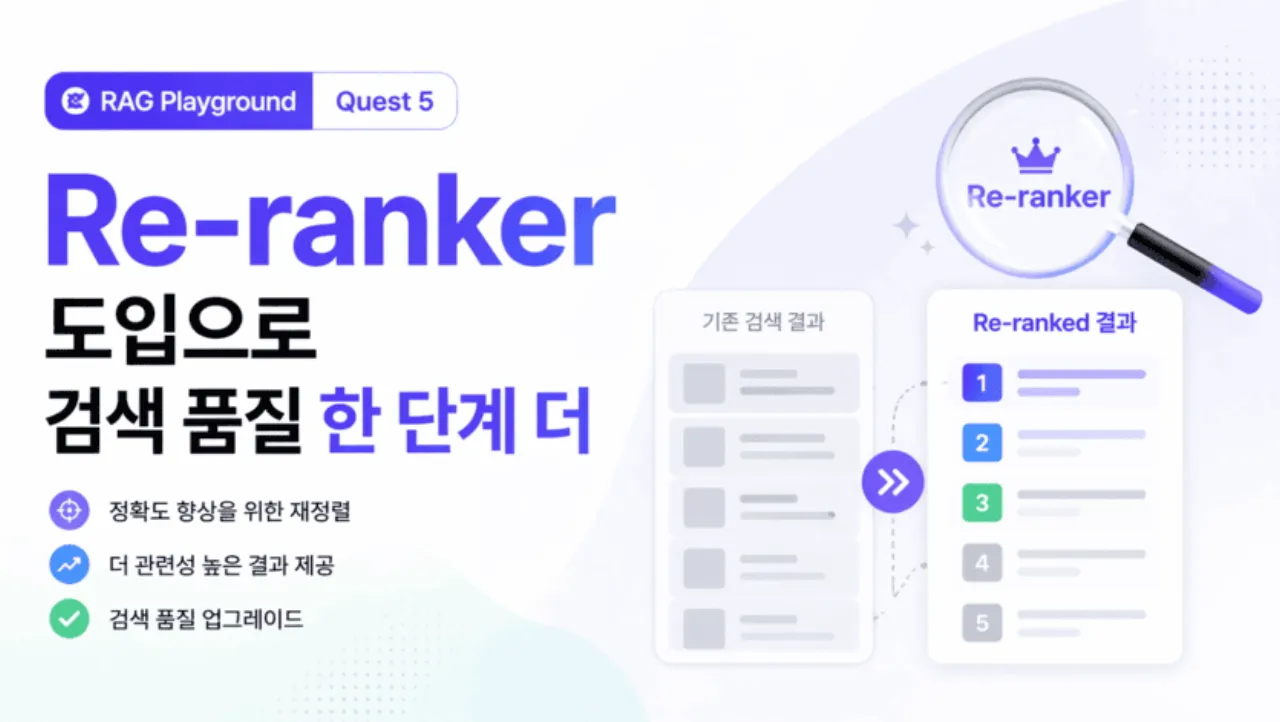
Hybrid Search로 후보를 뽑고, Re-ranker로 다시 정렬하는 2단계 파이프라인 구축기
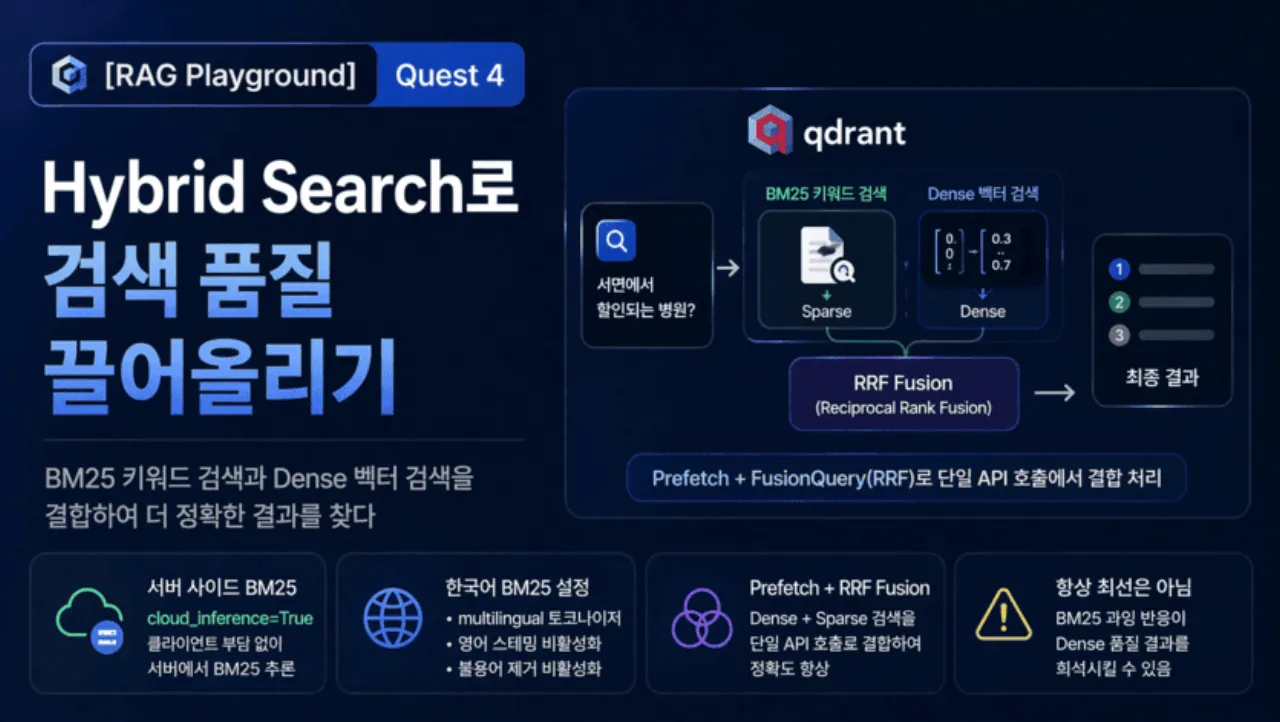
BM25 키워드 검색과 벡터 검색을 결합한 Hybrid Search 구현기 — Naive RAG의 한계를 정면 돌파합니다
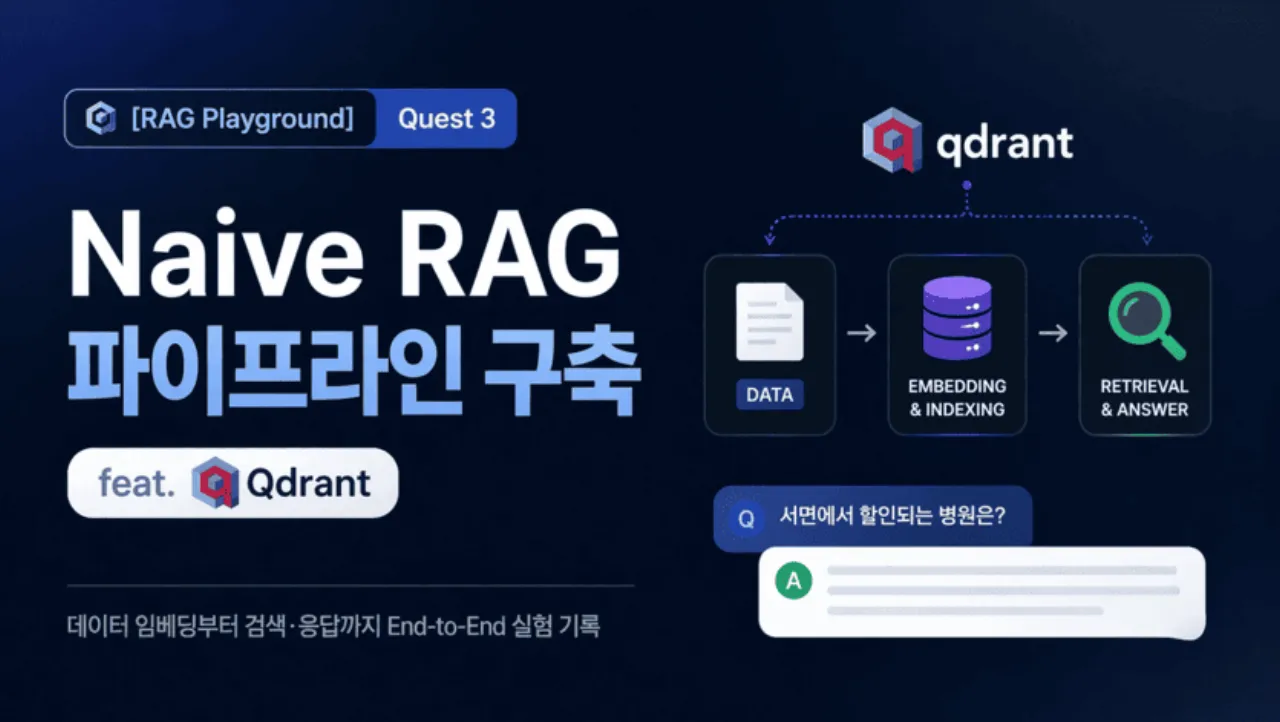
ChromaDB에서 Qdrant Cloud로 전환하고, OpenAI 임베딩 기반 Naive RAG 파이프라인을 완성하기까지
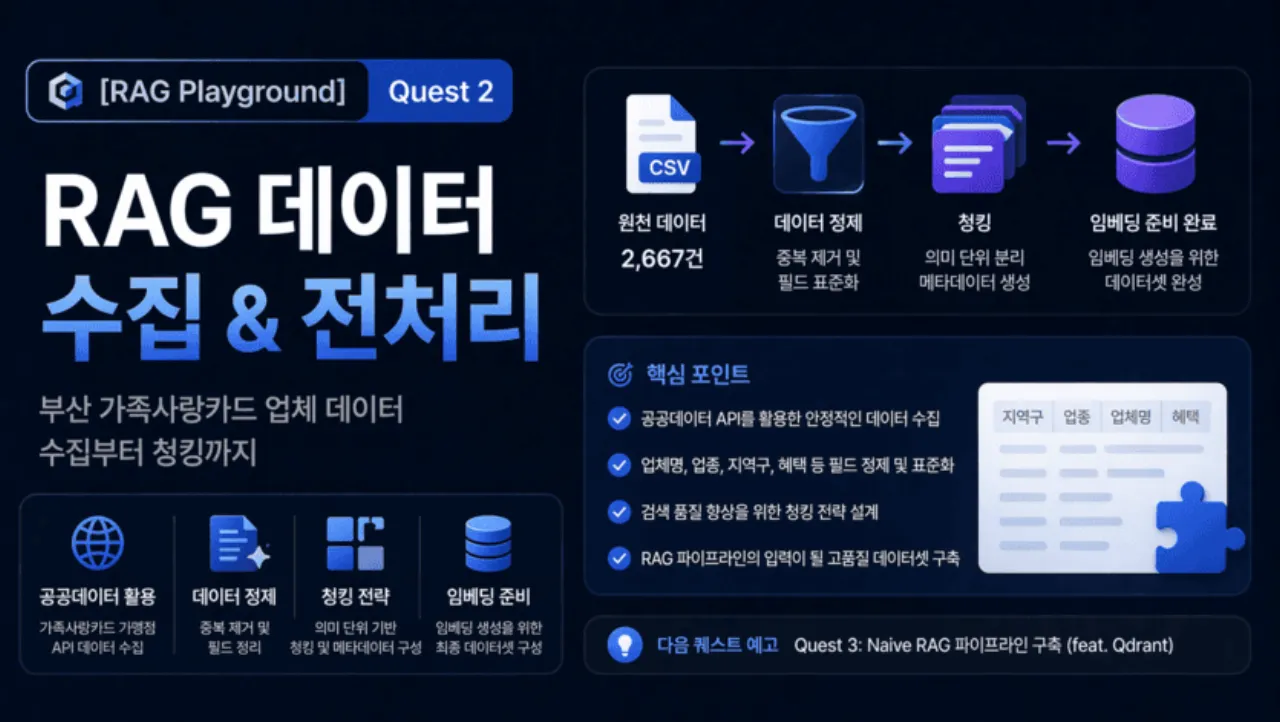
부산광역시 가족사랑카드 API 연동 및 데이터 정제 전략
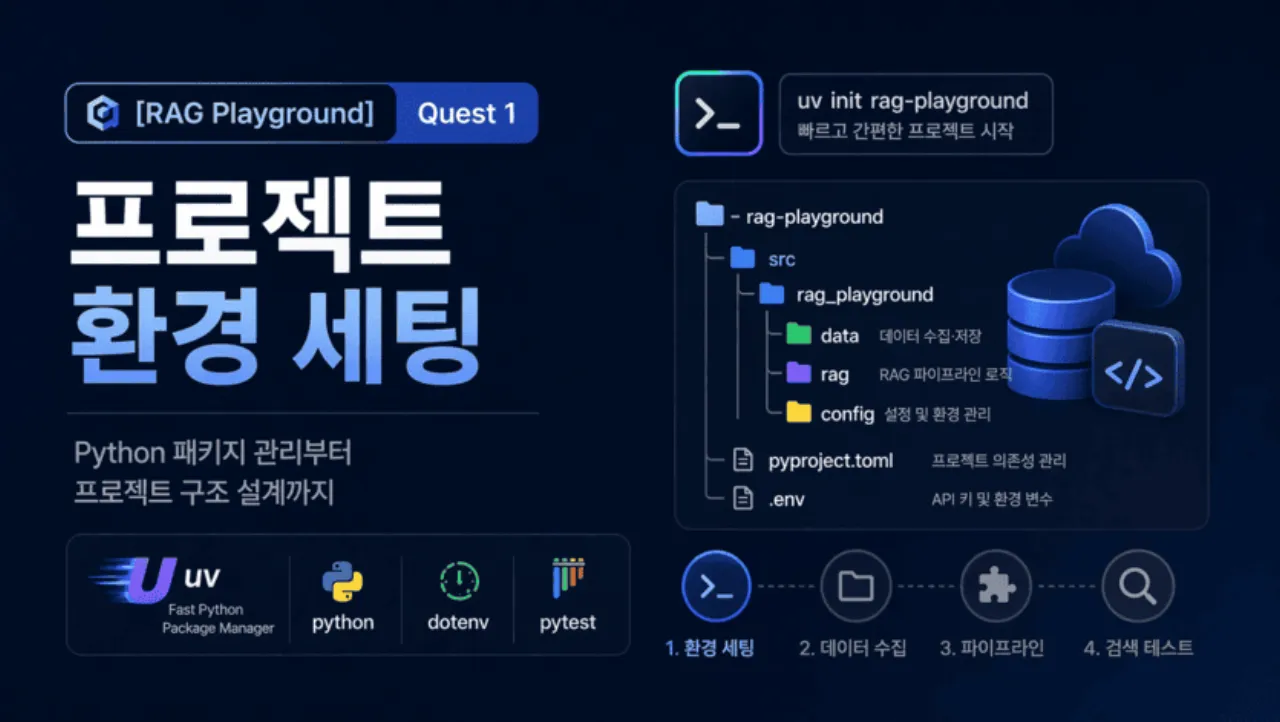
Python uv와 LangChain을 활용한 프로젝트 구조 설계
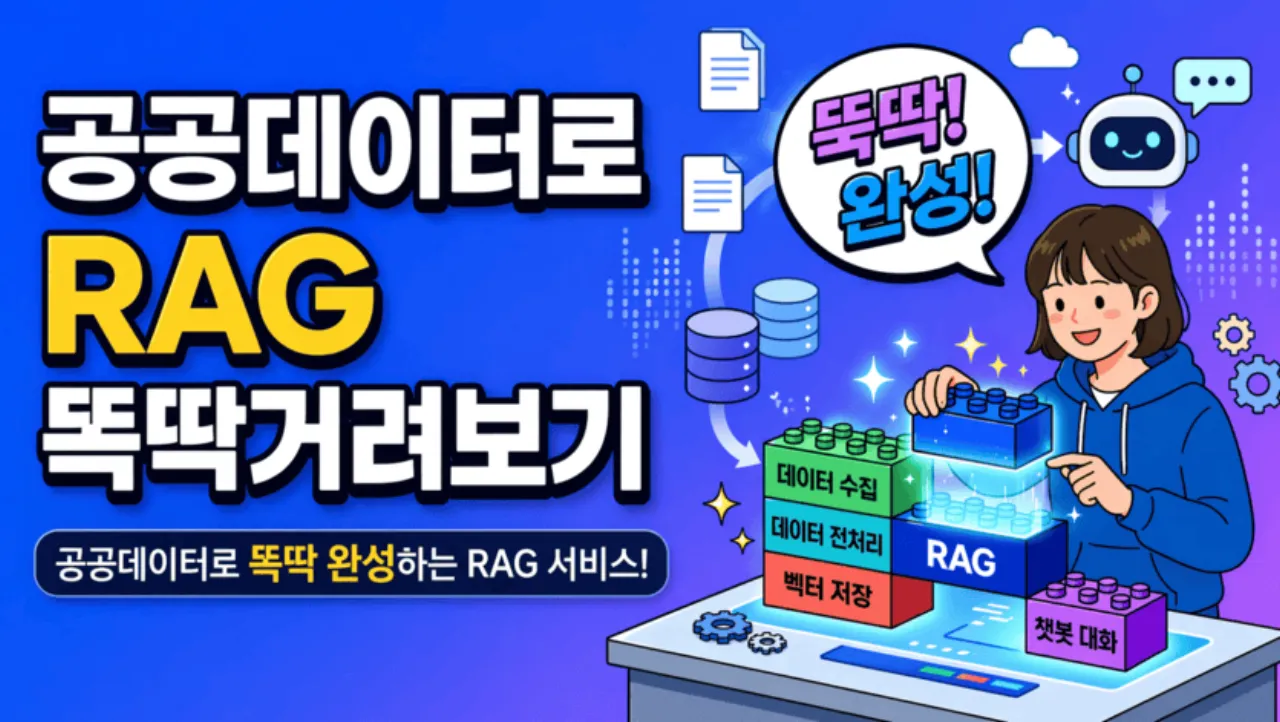
공공데이터포털 API를 활용한 RAG 에이전트 개발 프로젝트 시작
읽어주셔서 고맙습니다.